


複数品種のゲノムを比較し網羅的に構造多型を検出するLAYLAプログラム
要約
LAYLA(Large indel AnalYzer for muLti-sAmple)はロングリードシーケンサーの配列データとリファレンスゲノム配列を基に、各品種に存在する構造多型(一般的に50bp以上のゲノム変異を指す)を網羅的に検出し、品種横断的にその有無を可視化するプログラムである。
- キーワード : ゲノム変異、構造多型、ロングリードシーケンス、パイプライン、Python
- 担当 : 果樹茶業研究部門・カンキツ研究領域・カンキツ品種育成・生産グループ
- 代表連絡先 :
- 分類 : 研究成果情報
背景・ねらい
これまで、カンキツを含め多くの作物でゲノムの変異の情報が蓄積されているが、使用されたシーケンサーのリード長による制約から、検出された変異は一塩基多型のような小規模な変異(スモールバリアント)に偏っている。しかしながらトランスポゾンに代表されるように、実際にはより大規模な範囲でDNA配列の挿入・欠失及び再編成が生じる変異が存在する。このような、大規模な変異は構造多型(Structural Variant、SV)と呼ばれるが、その情報の蓄積は十分ではなく、形質との関連解明も含めて今後の活用が期待される。また、スモールバリアントはエラーによる誤検出や個体特異的な変異の割合が比較的高く、検出された変異は必ずしも応用可能ではない。これに対し構造多型はその規模の大きさから個体特異的変異が稀である。さらに、挿入・欠失を伴う変異については、その変異の有無により特定のゲノム領域でDNAの配列長が異なることを意味するため、PCR増幅産物のサイズの差異を利用して簡便にジェノタイピングが可能である。このような背景から構造多型の検出を容易にし、その情報の蓄積や利用を促進するため、従来よりリード長の長いロングリードシーケンサーに注目し、その配列データを基に、解析対象品種のゲノムに存在する構造多型を網羅的に検出するプログラムのLAYLAを開発した。また、テストケースとして日本のカンキツ育種における祖先13品種とウンシュウミカンを対象にLAYLAによる解析を行った。
成果の内容・特徴
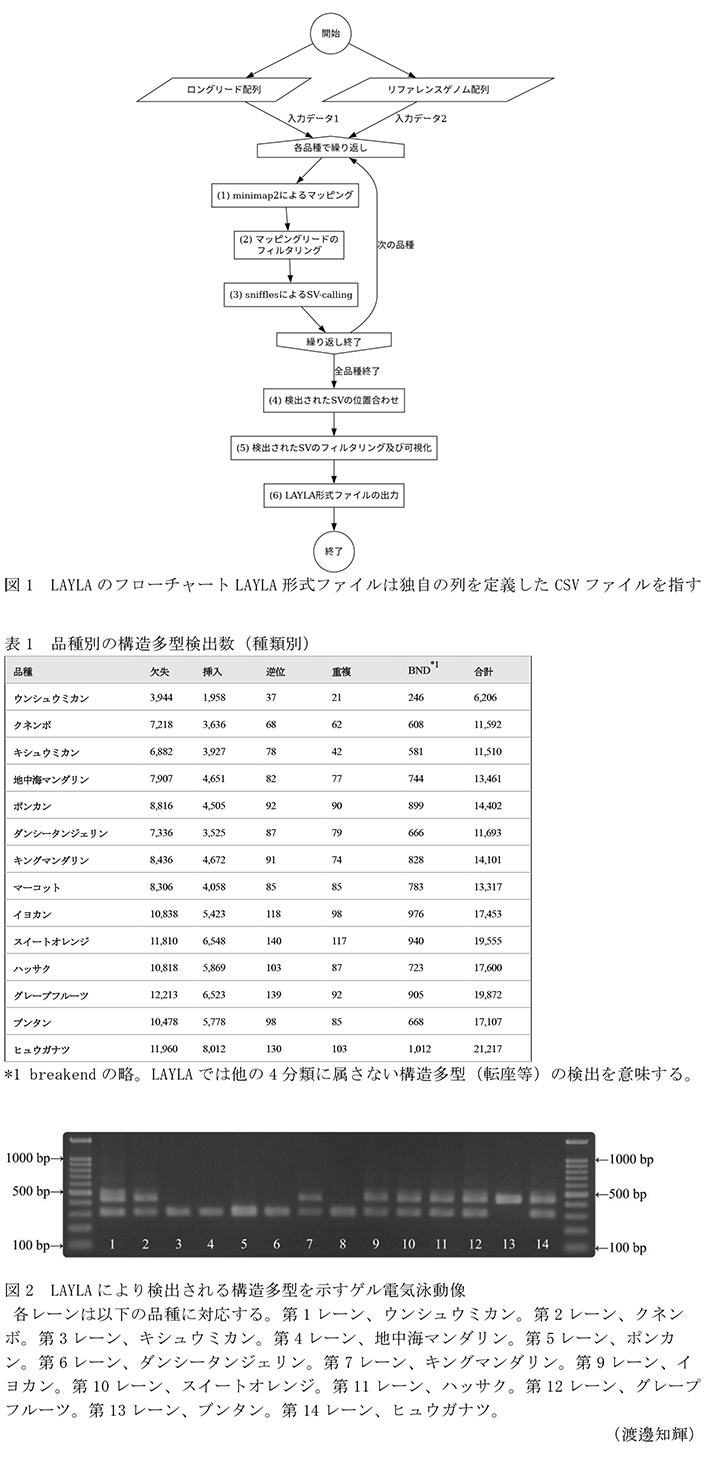
- LAYLAは解析対象品種のロングリード配列をリファレンスゲノムにマッピングし、リード配列とリファレンスゲノム配列の差異を基に構造多型を検出する。これを各品種で繰り返した後に結果を統合し、品種横断的にリファレンスゲノムの各位置に対して検出された構造多型について、変異の種類(欠失、挿入、逆位、重複、breakend)とジェノタイプ(ホモ変異、ヘテロ変異、変異無)を可視化する(図1)。実行時にアノテーション情報が与えられた場合、遺伝子領域やその上流領域に存在する構造多型の情報が別途出力される。
- LAYLAはPythonにより作成されたパイプラインプログラムであり、各プロセスの実行のために、外部プログラムのminimap2、samtools、snifflesに依存している。単一のコマンドにより品種横断的な構造多型の検出結果が記載されたCSVファイル(LAYLAファイル)の出力までのプロセスが実行される。
- 日本のカンキツ育種の祖先品種に位置づけられる13品種(クネンボ、キシュウミカン、地中海マンダリン、ポンカン、ダンシータンジェリン、キングマンダリン、マーコット、イヨカン、スイートオレンジ、ハッサク、グレープフルーツ、ブンタン、ヒュウガナツ)とウンシュウミカンの計14品種のロングリード配列データとウンシュウミカンのリファレンスゲノムデータを入力としてLAYLAを実行すると、リファレンスゲノムの59,983地点において少なくとも1つの品種に構造多型が検出される。いずれの品種でも多数の構造多型が検出されるが、各品種における検出数は異なり、これは使用したリファレンスゲノムに対するゲノム構造の類似性を反映していると考えられる(表1)。
- LAYLAにより検出された挿入または欠失変異が存在するゲノム領域を挟むように設計したプライマーを用いると、変異の有無を反映する異なるサイズのPCR増幅産物が得られると考えられる。LAYLAの性能検証のために、設計された9つのプライマーからは、実際に各品種で異なるバンドパターンが得られ、その結果から推定される各品種のジェノタイプはLAYLAによる推定結果とほぼ一致する。このことは、LAYLAがゲノム上に実際に存在する構造多型を検出可能であることを強く示唆する(図2)。
成果の活用面・留意点
- LAYLAにより解析対象品種の一部または全部に共通する構造多型や、特定の品種にのみ存在する構造多型の情報が得られるため、アノテーション情報と併用することで特定の形質と構造多型との関連解明が期待される。
- 特に挿入または欠失変異についてLAYLAにより品種間で多型が検出される箇所を含む領域を増幅するプライマーを設計することで、増幅サイズの差異を利用してゲル電気泳動でジェノタイプを識別可能なindelマーカーを設計可能である。
- LAYLAにより構造多型が検出されたゲノム領域では実際に品種間で多型が見られることが強く示唆されている。その一方で、LAYLAによる各品種のジェノタイプの推定精度は用いるロングリード配列のクオリティに依存する可能性が高い。特に総リード数が少ない場合、推定精度が低下するおそれがある。また、LAYLAによる構造多型の検出結果は、用いるリファレンスゲノムにより異なる。
具体的データ
その他
- 予算区分 : 交付金、文部科学省(科研費)
- 研究期間 : 2023~2025年度
- 研究担当者 : 渡邊知輝、遠藤朋子、川原善浩、白澤健太(かずさDNA研究所)、野中圭介、磯部祥子(東京大学)、島田武彦、後藤新悟、藤井浩(静岡大学)
- 発表論文等 :
- Watanabe T. et al. (2025) Breed. Sci. 75:442-454
- 渡邊ら(2024)職務作成プログラム「LAYLA」、機構-D11